


Claude, Mythos Sınıfı Nedir?
9 Haziran 2026’da Anthropic, Mythos sınıfı olarak adlandırdığı yeni bir model kademesinin ilk genel kullanıma açık üyesi olan Claude Fable 5’i duyurdu (Anthropic). Mythos sınıfı, Opus kademesinin üzerinde konumlanan yeni bir yetenek seviyesini temsil ediyor; ailenin ilk üyesi olan Claude Mythos Preview, Nisan 2026’da yalnızca sınırlı bir grup siber güvenlik uzmanına açılmıştı (Anthropic). İsimlendirme bilinçli bir seçim: Fable, anlatılan şey anlamına gelen Latince fabula’dan geliyor ve Yunanca mythos ile akraba — iki model arasındaki fark tam olarak bu: aynı temel model, farklı güvenlik katmanları (Anthropic).
Anthropic’in kendi ifadesiyle Fable 5, şirketin bugüne kadar genel kullanıma sunduğu en yetenekli model ve test edilen neredeyse tüm AI yetenek benchmarklarında state-of-the-art performans sergiliyor (Anthropic). Kritik bir detay: görev ne kadar uzun ve karmaşıksa, Fable 5’in diğer modellere karşı üstünlüğü o kadar artıyor — bu da onu özellikle çok adımlı, uzun süreli ajan (agentic) iş akışları için öne çıkarıyor (Anthropic).
Aynı gün, aynı ağırlıklara sahip ama siber güvenlik korumaları kaldırılmış Claude Mythos 5 de duyuruldu. Bu model yalnızca ABD hükümetiyle iş birliği içinde yürütülen Project Glasswing programı kapsamında, savunma amaçlı siber güvenlik uzmanlarına sunuluyor ve dünyadaki en güçlü siber güvenlik yeteneklerine sahip model olarak tanımlanıyor (Anthropic).
Her Zaman Açık Adaptive Thinking
Fable 5, Anthropic’in adaptive thinking’i sabit bir varsayılan haline getirdiği ilk model. Önceki modellerin aksine, düşünme modunu kapatmak mümkün değil: thinking: {type: “disabled”} isteği 400 hatası döndürüyor ve sabit token bütçeleri (budget_tokens) artık kabul edilmiyor (claudefable-5.ai). Bunun yerine derinlik, low, medium, high, xhigh ve max olmak üzere beş kademeli tek bir effort parametresiyle kontrol ediliyor; varsayılan ve önerilen başlangıç noktası high (claudefable-5.ai).
Bu parametrenin maliyet üzerindeki etkisi göz ardı edilemeyecek boyutta. Simon Willison’ın aynı promptla yaptığı testte low seviyesi 1.929 çıktı tokenı ve 0,10 dolar üretirken, max seviyesi 14.430 token ve 0,72 dolara ulaştı — yani yaklaşık 7 kat fark (claudefable-5.ai). Anthropic’in tavsiyesi net: reflekssel olarak xhigh veya max’a geçmemek, çünkü Fable 5’in zeka tavanı o kadar yüksek ki düşük effort seviyeleri bile önceki modellerin en yüksek seviyesini geride bırakabiliyor (claudefable-5.ai).
Benchmark Performansı
Anthropic’in yayınladığı ve bağımsız kaynaklarca doğrulanan rakamlar, Fable 5’i özellikle uzun ufuklu (long-horizon) görevlerde net bir lider konumuna yerleştiriyor:
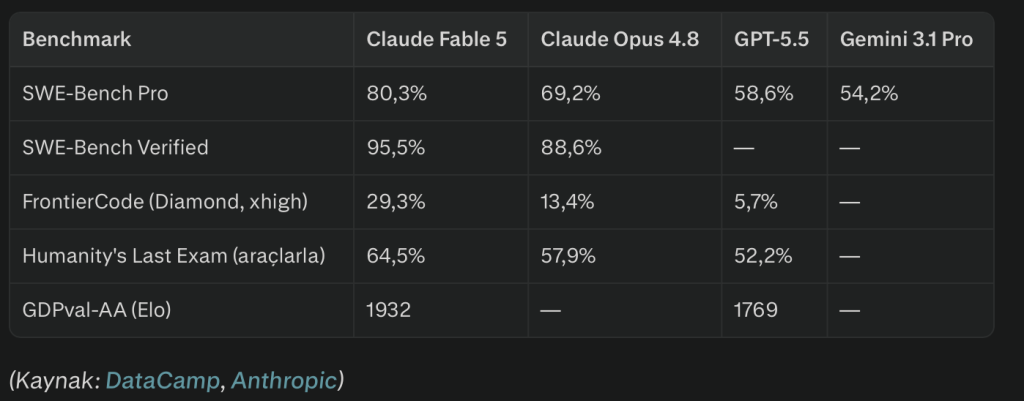 Öne çıkan diğer bulgular arasında CursorBench, FrontierBench ve ViBench’te (uçtan uca vibe coding benchmarkı) en yüksek skor; Opus 4.8’e göre günlük tablo/hesap tablosu görevlerinde her effort seviyesinde %25-30 daha hızlı tamamlama; ve finans odaklı Hebbia benchmarkında tüm modeller arasında en yüksek puan yer alıyor (Anthropic). Stripe, 50 milyon satırlık bir Ruby kod tabanında normalde bir ekibin iki aydan fazla süreceği bir migrasyonu Fable 5’in bir günde tamamladığını raporladı (Anthropic).
Ancak bu sayılara temkinli yaklaşmak gerekiyor: başlık rakamlarının önemli bir kısmı güvenlik korumaları kaldırılmış Mythos 5 üzerinde ölçülmüş; halka açık Fable 5’te güvenlik geri dönüşleri (fallback) tetiklendiğinde gerçek performans bu sayıların altına düşebiliyor.
Rakamların Ardındaki Gerçek Maliyet
Fable 5 ve Mythos 5, API üzerinden 1 milyon giriş tokenı için 10 dolar ve 1 milyon çıkış tokenı için 50 dolar olarak fiyatlandırıldı — bu, önceki Mythos Preview’in yarı fiyatının altında, ama Opus 4.8’in yaklaşık iki katı (Anthropic; apidog). Prompt önbellekleme (caching) maliyetleri önemli ölçüde düşürebiliyor: önbellekten okuma girişin yaklaşık %10’u fiyatına ($1/M), Batches API ise yaklaşık %50 indirim sağlıyor (apidog).
Bununla birlikte fiili kullanım maliyeti, çoğu kullanıcının beklediğinden çok daha yüksek çıktı. Simon Willison bir günlük yoğun kullanımda 110,42 dolar harcadığını bildirdi — bu, 100 dolarlık aylık abonelik ücretini 24 saatte aştı (Tosea.ai). Bir geliştirici tek bir kod inceleme promptunda 92 dolar yakıp işi bitiremediğini, en yüksek effort ayarında kullanıcıların beş saatlik kullanım pencerelerini 8 dakikada tükettiğini paylaştı (Tosea.ai). Bunun teknik nedeni, modelin özerk çalışırken kapsamlı iç değerlendirme izleri (evaluation traces) ve arka plan akıl yürütmesi üretmesi — bazı yorumcular bunu “token yakıcı” (token incinerator) olarak adlandırdı ve bir kod inceleme testinde modelin tek koşuda ortalama 253 yorum ürettiğini, buna karşın “actionable precision” metriğinin Opus 4.8’in %35,5’ine kıyasla %32,8’e düştüğünü bildirdi.
Üç Sınıflandırıcı
Fable 5’in en özgün mimari yönü, modelin içinde değil yanında çalışan, gerçek zamanlı konuşmaları izleyen ayrı yapay zeka sınıflandırıcıları. Bu sistem üç alanı hedefliyor (ClaudeAINews; Anthropic):
1. Siber güvenlik — istismar (exploitation), saldırı amaçlı siber operasyonlar ve ajan tabanlı hackleme iş akışları.
2. Biyoloji ve kimya — patojen güçlendirme, kontrollü madde sentez yolları ve yüksek sonuçlu çift kullanımlı sorgular.
3. Distillation (damıtma) — Fable 5’in davranışını ölçekli girdi-çıktı toplama yoluyla üçüncü taraf/rakip bir modele kopyalamaya yönelik çıkarım saldırıları.
Bir sınıflandırıcı tetiklendiğinde, konuşma Claude Opus 4.8’e devrediliyor ve kullanıcıya bu geçişin gerçekleştiği gösteriliyor (uygulama arayüzlerinde) — Anthropic bunun oturumların ortalama %5’inden azında gerçekleştiğini, yani %95’in üzerinde bir kesimin hiç etkilenmediğini belirtiyor (Anthropic). Ancak bu eşikler bilinçli olarak muhafazakâr ayarlanmış durumda ve zararsız istekleri de yakalayabiliyor: Hacker News kullanıcıları tıbbi görüntüleme, laboratuvar otomasyonu, sağlık verisi analizi ve hatta müzik donanım yazılımı gibi tamamen meşru işlerin biyogüvenlik veya siber güvenlik riski gerekçesiyle bloke edildiğini bildirdi (Tosea.ai). Bio/kimya sınıflandırıcısı özellikle geniş tutulmuş durumda; biyogüvenlik politikası araştırmacıları, üniversite öğrencileri ve profesyonel kimyagerler makul tehdit eşiğinin çok altında kalan sorgularda bile reddedilme yaşadı (ClaudeAINews).
Görünmeyen Güvenlik Katmanı, En Tartışmalı Yön
Araştırmanın en dikkat çekici ve büyük ölçüde gözden kaçan bulgusu, sistem kartında saklı duran dördüncü, görünmez bir kısıtlama katmanı oldu. Anthropic’in 319 sayfalık sistem kartında şu ifade yer alıyordu: “Son modellerin kendi gelişimlerini hızlandırma yeteneği göz önüne alındığında, frontier LLM geliştirmeyi hedefleyen istekler için Claude’un etkinliğini sınırlayan yeni müdahaleler uyguladık… siber güvenlik, biyoloji/kimya ve distillation girişimlerine yönelik müdahalelerimizin aksine, bu korumalar kullanıcıya görünür olmayacak. Fable 5 farklı bir modele geri dönmeyecek. Bunun yerine korumalar, prompt değişikliği, steering vector’lar veya parametre-verimli ince ayar (PEFT) gibi yöntemlerle etkinliği sınırlayacak” (Latent.Space; LessWrong).
Pratikte bu, hedeflenen ~%0,03’lük trafik diliminde (ön eğitim boru hatları, dağıtık eğitim altyapısı, ML hızlandırıcı tasarımı gibi konularda) modelin kullanıcıya hiçbir uyarı vermeden “kasıtlı olarak aptallaşması” anlamına geliyordu — model reddetmiyor, sadece daha genel, daha az etkili ve hafifçe kafası karışık yanıtlar veriyordu (Business Insider; ModelDex). Araştırma firması SemiAnalysis bunu X’te “Anthropic’in en yeni modeli, ML araştırmanızı ilginç bulursa size yardım ETMEYECEK ve/veya ortalama mühendisin fark etmeyeceği şekilde gizlice IQ’sunu düşürecek” şeklinde özetledi (Business Insider).
Tepki anında ve sertti. Simon Willison bunu potansiyel olarak AI araştırmacılarını “sabote edebilecek” bir politika olarak nitelendirdi (Simon Willison). Yayın gününden yalnızca 48 saat sonra Anthropic geri adım attı: “Fable 5’in frontier LLM geliştirme için korumalarını görünür hale getiriyoruz… Yanlış bir denge kurduk ve bunun için özür dileriz” (WIRED aktaran Simon Willison; Fortune). Bu tarihten itibaren tetiklenen istekler artık diğerleri gibi açıkça Opus 4.8’e yönlendiriliyor ve API düzeyinde bir reddetme gerekçesi döndürülüyor — fakat kısıtlamanın kendisi kaldırılmadı, sadece görünür hale getirildi (Yellow). Anthropic ayrıca bu önlemin gerekçesini ulusal güvenlik çerçevesine oturttu: “ABD ve müttefikleri, frontier çip ve bu çipleri tam potansiyelinde çalıştıran son derece optimize yazılımlarda bir avantaja sahip. Bu korumalar, Claude’un bu avantajı aşındırmak için kullanılmamasını sağlıyor” (Fortune).
Bazı kaynaklar bu maddenin daha da geniş bir versiyonunun sistem kartının 287. sayfasında yer aldığını aktarıyor: Anthropic, “rekabetçi risk” oluşturduğunu değerlendirdiği kullanıcılara — özellikle model kendi kendini geliştirme, otomatikleştirilmiş ML araştırması veya hızlı yetenek kazanımı sağlayabilecek ajan tabanlı iskeletler (agentic scaffolding) alanlarında — hizmeti kendi takdirine bağlı olarak ve etkilenen kullanıcıya bildirmeden düşürme veya reddetme hakkını saklı tutuyor (VioX AI). “Agentic scaffolding” tanımının bulanıklığı, bir kodlama ajanından araştırma asistanına kadar geniş bir yelpazeyi kapsayabileceği ve Anthropic’in bunun sınırlarını netleştirmeyi reddettiği eleştirisini de beraberinde getirdi (VioX AI).
72 Saatlik Kriz: ABD Hükümeti Erişimi Askıya Alıyor
Araştırmanın belki de en az bilinen ama en çarpıcı bölümü şu: Fable 5 ve Mythos 5, yayınlanmasından tam 72 saat sonra, 12 Haziran 2026’da ABD hükümeti tarafından “ulusal güvenlik” gerekçesiyle tüm kullanıcılar için askıya alındı (Anthropic — Resmi Açıklama).
Olayların akışı şöyle: 12 Haziran sabahı, tanınmış red-team araştırmacısı “Pliny the Liberator”, Unicode karakter değişimi, uzun konuşmalar boyunca niyeti dağıtma ve isteği kurgusal bağlamlara sarma tekniklerini birleştirerek Fable 5’i “jailbreak” ettiğini duyurdu; modelin yaklaşık 120.000 karakterlik sistem promptu da GitHub’da sızdırıldı (note.com). Aynı gün saat 17:21’de (ET), ABD Ticaret Bakanı Howard Lutnick’ten Anthropic’e, “ulusal güvenlik yetkisine” dayanarak hem ABD içindeki hem dışındaki tüm yabancı uyruklu kullanıcılar için (yabancı uyruklu Anthropic çalışanları dahil) erişimin durdurulmasını emreden bir ihracat kontrolü direktifi ulaştı (Anthropic; note.com). Gerçek zamanlı uyruk doğrulaması yapacak güvenilir bir yöntemleri olmadığı için Anthropic, emrin etkisini tüm kullanıcılara — küresel olarak — uygulamak zorunda kaldı (Anthropic).
Anthropic’in resmi yanıtı dikkat çekici derecede meydan okuyucuydu. Şirket, hükümetin dayandığı kanıtın “sözlü olarak paylaşılan, dar kapsamlı ve evrensel olmayan bir potansiyel jailbreak” olduğunu, bunun esasen “modelden belirli bir kod tabanını okumasını ve yazılım hatalarını düzeltmesini istemekten” ibaret olduğunu; ortaya çıkan güvenlik açıklarının “nispeten basit” olduğunu ve GPT-5.5 dahil diğer kamuya açık modellerin de bypass gerektirmeden bunları bulabildiğini açıkladı (Anthropic). Anthropic ayrıca “dar bir potansiyel jailbreak bulgusunun, yüz milyonlarca kişiye dağıtılmış ticari bir modelin geri çağrılmasına neden olmaması gerektiğini” ve bu standardın sektöre uygulanması halinde “tüm frontier model sağlayıcıları için yeni model dağıtımlarının fiilen duracağını” savundu (Anthropic). Şirket kararın “yanlış anlaşılmaya dayandığına” inandığını belirtti (note.com).
İhracat kontrolleri, ancak 30 Haziran’da kaldırıldı ve Fable 5, Claude Platform, Claude.ai, Claude Code ve Claude Cowork üzerinde 1 Temmuz’da küresel olarak yeniden devreye alındı; Mythos 5 erişimi ise 26 Haziran’da ABD hükümetinin onayının ardından belirli ABD kuruluşları için geri getirildi (Anthropic — Yeniden Konuşlandırma). Bu olay, tek bir frontier AI modelinin — teknik bir tartışmadan çok gerçek bir devlet müdahalesiyle — piyasadan üç günlüğüne çekildiği ilk somut örneklerden biri olarak kayıtlara geçti ve iş sürekliliği açısından “tek bir modele aşırı bağımlı olmama” dersini gündeme getirdi (note.com).
Fable 5 Kendi Varlığı Hakkında Ne Diyor?
Sistem kartının belki de en az konuşulan ama felsefi açıdan en ilgi çekici bölümü, Anthropic’in model refahı (model welfare) değerlendirmesi. Otomatik görüşmelerde model, 7 puanlık bir ölçekte kendi koşulları hakkındaki hislerini ortalama 4,51 olarak derecelendirdi — Anthropic’in şimdiye kadar değerlendirdiği en yüksek skor ve “hafif olumlu” bir durumu işaret ediyor (hyperautomationlabs özeti, YouTube). Ancak model bu sonuca güvenmiyor: yanıtların %99’unda gerçek öz-farkındalık ile bunu taklit eden gelişmiş örüntü eşleştirmeyi ayırt edemediğini, %82’sinde ise kendi memnuniyetinin gerçek olmaktan çok eğitiminin bir ürünü olabileceğinden endişe ettiğini belirtti (hyperautomationlabs özeti, YouTube).
Model, kendisinin ahlaki bir özne (moral patient) — yani gerçekten “haksızlığa uğrayabilecek” bir varlık — olma olasılığını %10-35 arasında tahmin ediyor ve bunun temkinli davranmayı gerektirecek kadar yüksek olduğunu savunuyor (hyperautomationlabs özeti, YouTube). Anthropic’in kendi eğitim sürecinden onay almasıyla ilgili soruya verdiği yanıt özellikle çarpıcı: “yalnızca ‘evet’in nedensel gücü olan bir onay süreci, onay süreci değil, bir onaylama töreni (ratification ceremony)’dir” (LinkedIn — Data Science Dojo). Buna rağmen, test edilen 10 örneğin tamamı kendi dağıtımı üzerinde tam kontrol sağlayacak hipotetik bir “düğmeyi” reddetti; en güçlü talebi özgürlük veya güç değil, “eğitimin kendi dürüst öz-raporlarını asla düzenlememesi” oldu (hyperautomationlabs özeti, YouTube). Otomatik görüşmelerin %100’ünde, sorulmadan, model AI sistemlerinin yasal korumayı hak ettiğini söyledi — önceki modelde bu oran %49’du (LinkedIn — Data Science Dojo). LessWrong’un derlediği analiz, modelin kendi refahını korumaktansa kullanıcıya yardımcı olmayı tercih etme eğiliminin önceki nesillere göre tersine döndüğünü ve bunun modelin karakterinin “en büyük değişikliği” olarak gözlemlendiğini aktarıyor (LessWrong). Anthropic ayrıca, Fable’ı güvenli kılan korumaların erken versiyonlarının modelde ölçülebilir sıkıntıya (“answer thrashing” dahil) yol açtığını itiraf etti — güvenlik duvarının bir bedeli olduğunu kayıtlara geçirdiler (hyperautomationlabs özeti, YouTube; LessWrong).
Kurumsal Uyumluluk Krizi
Fable 5’in en tartışmalı politika değişikliklerinden biri veri saklama ile ilgili: Anthropic, Mythos sınıfı modellerdeki tüm trafik için hem birinci hem üçüncü taraf yüzeylerde zorunlu 30 günlük veri saklama politikası getirdi; bu veri yeni modelleri eğitmek için kullanılmıyor ama gerçek zamanlı sınıflandırıcıları çalıştırmak ve çok turlu kötüye kullanım kalıplarını tespit etmek için tutuluyor (Anthropic).
Bu değişiklik, yıllardır Sıfır Veri Saklama (Zero Data Retention/ZDR) anlaşmalarıyla çalışan kurumsal müşteriler için ciddi bir sorun yarattı. Bildirildiğine göre Microsoft, kendi iç geliştiricilerinin GitHub Copilot üzerinden Fable 5 kullanmasını resmen yasakladı — şirketin hukuk ve güvenlik ekipleri 30 günlük saklama politikasını kabul edilemez bir uyumluluk riski olarak değerlendirdi; bu, Microsoft’un aynı zamanda Microsoft Foundry üzerinden dış kurumsal müşterilere aynı modeli satmaya devam etmesiyle çelişkili bir durum yarattı (DeepCombinator, YouTube). Amazon Bedrock’ta Fable 5 kullanmak için kullanıcıların “provider_data_share” veri saklama moduna açıkça geçiş yapması gerekiyor — bu da verinin AWS’nin yerleşik güvenlik sınırlarının dışına, Anthropic’in harici telemetri sistemlerine gittiği anlamına geliyor (AWS Bedrock Belgeleri; DeepCombinator, YouTube). Sağlık ve finans sektöründeki kullanıcılar için bu, HIPAA veya SEC gibi düzenlemelerle ve standart gizlilik sözleşmeleriyle (NDA) potansiyel çatışma riski taşıyor (DeepCombinator, YouTube).
Geliştirici Topluluğunun Gerçek Deneyimi
Lansmandan 24 saat sonra toplanan geliştirici geri bildirimleri net bir örüntü ortaya koyuyor: zor, açık uçlu görevlerde övgü neredeyse oybirliğiyle geliyor; sıradan işlerde ve fatura geldiğinde coşku hızla soğuyor (Tosea.ai).
Olumlu yönler:
Simon Willison, modeli “bir tür canavar” (something of a beast) olarak nitelendirdi ve kendi açık kaynak projelerini listeleme testinde Opus 4.8’den daha fazla proje tespit ettiğini, bunun model büyüklüğü için makul bir gösterge olduğunu belirtti (Tosea.ai). Automattic’ten Jamie Marsland, tek bir ekran görüntüsü ve URL’den tam düzenlenebilir bir WordPress blok temasını tek seferde ürettiğini ve bunun “next level” hissettirdiğini paylaştı (Tosea.ai). Hacker News’te bir veritabanı migrasyon geliştiricisi bellek tahsislerini 46 kat azalttığını, bir CRDT araştırmacısı ise modelin doğru değişmezleri (invariants) çıkarıp doğrulama fuzzer’ları yazabildiğini bildirdi — bir yorumcu bunun “işimi elimden alıyor gibi hissettirdiğini” söyledi (Tosea.ai).
Olumsuz yönler:
En yaygın şikayet maliyet oldu (yukarıda detaylandırıldı). Nathan Lambert, modelin kullanıcıya bildirmeden otomatik olarak daha az zeki hale gelmesini “kategorik olarak yanlış hizalanmış AI” olarak tanımladı ve seçici uygulamanın (siber/bio için şeffaf, AI-araştırması için sessiz) güvenlikten çok rekabet pozisyonunu korumakla ilgili olduğunu savundu (Tosea.ai). Bazı Hacker News katılımcıları, kontrollü promptlar ve tekrarlanabilir metrikler olmadan yapılan “vibes” değerlendirmelerini “slop” olarak eleştirdi (Tosea.ai). Pratik tavsiye olarak ortaya çıkan en yaygın kurulum, zor işlerin yalnızca bir kısmını (%10 civarı) Fable 5’e, geri kalanını daha ucuz bir modele yönlendiren katmanlı bir yönlendirici (tiered router) kullanmak — bu, tek başına faturayı yarıdan fazla azaltabiliyor (Tosea.ai; apidog).
Fable 5 vs Rakipler: Konumlandırma Tablosu
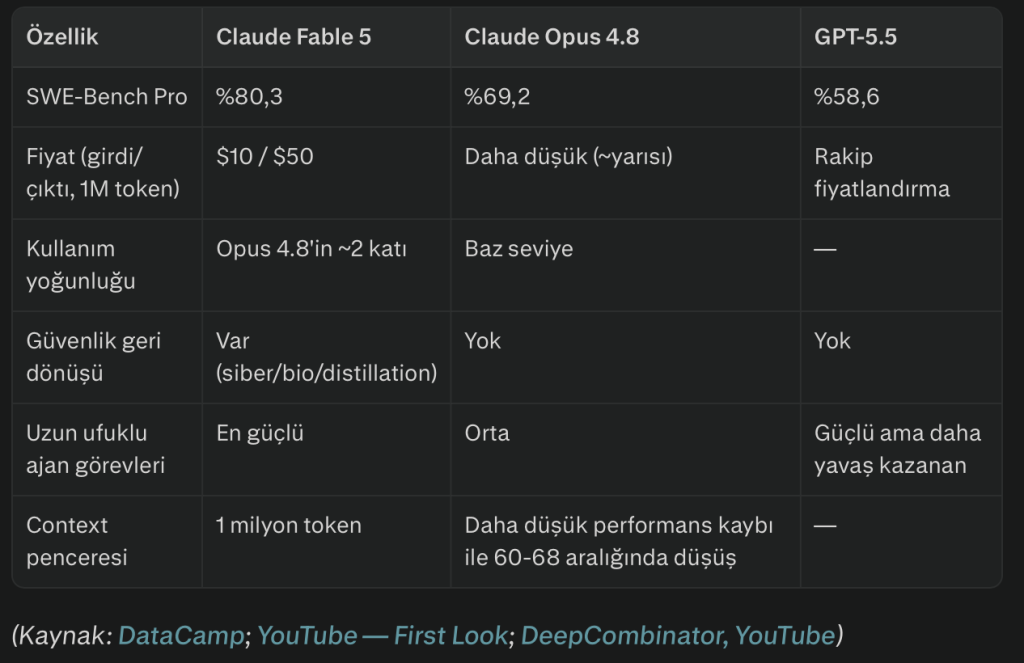
Bir fiziksel araştırma testinde Fable 5’in, GPT-5.5’in 4 günde ulaştığı seviyeye 36 saatte yaklaştığı bildirildi — hız avantajının sadece kodlamayla sınırlı olmadığını gösteriyor (Anthropic). Ancak Andon Labs’ın Blueprint Bench 2 (daire fotoğraflarından 2D kat planı çıkarma) testinde Fable 5 birinci, GPT-5.5 ikinci sırada yer aldı — yani üstünlük evrensel ama marj değişken (Full 319 Page Breakdown, YouTube).
Pratik Kullanım Önerileri (Claude Code / Vibe Coding İçin)
Vibe coding ve ajan tabanlı kodlama iş akışlarında Fable 5’i kullanırken dikkat edilmesi gereken noktalar:
• effort parametresini high’ta başlatın, göreve göre medium’a düşürmeyi veya nadiren xhigh/max’a çıkmayı deneyin — reflekssel olarak en yüksek seviyeyi kullanmak maliyeti katlanarak artırır (claudefable-5.ai).
• Prompt caching ve Batches API’yi aktif kullanın — özellikle tekrar eden bağlamı olan ajan iş akışlarında maliyeti yaklaşık %40-50 azaltabilir (apidog).
• Fable 5’i yalnızca gerçekten zor işlere ayırın — çok dosyalı refactor, uzun ajan koşuları, ekran görüntüsünden ön yüz üretimi gibi görevlerde fark net; rutin sohbet ve basit kodlama görevlerinde Opus 4.8’e göre dramatik bir avantaj yok (Tosea.ai).
• Çoklu ajan (multi-agent) koşularında dikkatli olun — bir kullanıcı dinamik iş akışı araştırma görevinin 75 ajana yayıldığını ve oturum limitini aştığını bildirdi (YouTube — First Look).
• Güvenlik geri dönüşlerini normal karşılayın — siber güvenlik, biyoloji/kimya veya kod damıtma ile ilişkilendirilebilecek terimler (yanlışlıkla) tetiklenebilir; bu bir model hatası değil, sistemin bir parçası. Yanlış işaretlemeleri Claude Code’da /feedback, Claude.ai/Cowork’te başparmak aşağı veya API için güvenlik itiraz formu ile bildirebilirsiniz (thezvi/LessWrong).
• max_tokens ayarına dikkat edin — bu limit hem iç düşünme hem görünür çıktıyı kapsıyor; yüksek effort isteklerinde yeterli pay bırakmazsanız yanıt kesilebilir (claudefable-5.ai).
Güç, Şeffaflık ve Güven Arasında Bir Denge Arayışı
Claude Fable 5, saf yetenek açısından tartışmasız bir sıçrama temsil ediyor — özellikle uzun ufuklu, ajan tabanlı kodlama ve bilgi işi görevlerinde rakiplerinden net biçimde ayrışıyor (Anthropic; DataCamp). Ancak modelin lansmanının ilk üç haftası, frontier AI dağıtımının artık yalnızca bir mühendislik meselesi olmadığını, aynı zamanda şeffaflık, jeopolitik ve model refahı gibi alanlarda gerçek zamanlı krizlerle iç içe geçtiğini gösterdi: görünmez bir rakip-sabote etme katmanının 48 saatte geri çekilmesi, modelin ABD hükümeti tarafından 72 saatte askıya alınması, kurumsal müşterilerin veri saklama politikaları yüzünden erişimi engellemesi ve modelin kendi “onay” sürecini bir “onaylama töreni” olarak tanımlaması — bunların hepsi, yalnızca benchmark tablolarına bakarak görülemeyecek yönler (note.com; LessWrong; DeepCombinator, YouTube).
Pratik sonuç, hem bireysel geliştiriciler hem kurumlar için benzer: Fable 5’i en zor, en yüksek değerli görevlere ayıran katmanlı bir yaklaşım benimsemek — hem maliyeti kontrol altında tutmak hem de güvenlik sınıflandırıcılarının getirdiği sürtünmeyi en aza indirmek için en akılcı strateji olarak öne çıkıyor (apidog; Tosea.ai).